この数日のClaude新モデル公開は、本当に大きかった
この数日で、Xのタイムラインの空気が変わりました。AnthropicがClaudeの新しいモデル「Fable 5.2」と「Mythos 5.2」を公開したと、複数の投稿が伝えています。
紹介している投稿によると、前の版より出力が最大3割速くなったそうです。さらに、プログラムを書く力を測るテストでは、Fable 5.2を中くらいより上の設定で動かすと、上位モデルのOpus 5.5をいちばん深い設定で動かしたときと同じくらいの成績を、約半分のコストで出したといいます。
性能が上がって、費用は半分。これほど分かりやすい数字は、そう出てきません。待っていた人が一気に反応したのも、うなずけます。
ただ、ここで一度立ち止まってほしいのです。新しいモデルが出るたびに設定をいちばん上に上げ、なんとなく触って「すごい」と感じて終わる。翌週の仕事の進め方は、何も変わっていない。AIは触ったけれど仕事は変わっていない、という状態は、こうした流れから生まれやすいものです。本業を回しながらAIに時間を割く40〜50代の方ほど、この繰り返しは痛手になります。新しい発表を追う時間が、そのまま本業から削られるからです。
もう一つ、見落とされやすい事実があります。ClaudeのアプリとClaude Codeでは、考える深さ(effort)の初期設定が「中くらい」になっています。effortとは、AIが答えを出す前に、どれだけ時間をかけて考えるかを決める目盛りのことです。何も触らなければ、中くらいで動く。今回の話の入口は、ここにあります。
新しい道具が出たとき、何を基準に向き合えばいいのか? 今日はその考え方と、記事を閉じてすぐに試せる手順を、講義で話している内容とあわせてお渡しします。
昔は「いちばん上」、今は「仕事に合う目盛り」
少し前までは、AIの選び方は単純でした。いちばん新しくて、いちばん上のモデルを、いちばん深い設定で使えば、いちばん良い答えが返ってくる。そう考えておけば、大きく外れることはありませんでした。
今は事情が違います。今回の数字が示しているのは、中くらいより上の設定にした下位のモデルが、上位モデルの最大設定に並ぶこともある、ということです。選べる目盛りが増え、上を選べば正解とは限らなくなりました。
なぜ、こうなったのでしょうか? 理由は2つあります。
・モデルの数と、考える深さの段階が増え、組み合わせが一気に広がった
・深く考えさせるほど待ち時間と費用がかかるため、仕事によっては速さを取ったほうが得になる
ここで、増えるものと追いつかないものを分けてみます。増えるのは、モデルと設定の選択肢です。追いつかないのは、自分の仕事にとって何が「良い答え」なのかという判断の基準です。基準がないまま選択肢だけが増えると、新しいモデルが出るたびに迷い、毎回やり直しになります。
僕は講義の第2回で、判断基準は土台で、事業はその上に乗るアプリだと話しました。iPhoneのOSがなければ、どんな優秀なアプリも動きません。AIのモデルも同じで、Fable 5.2もMythos 5.2も、上に乗るアプリの側です。土台の基準が1つ決まっていれば、どのモデルが来ても同じ物差しで測れます。
もう一つ。今回の成績は、コーディングのテストの話です。「プログラムの話だから自分には関係ない」と感じた方もいるでしょう。第3回の講義では、工場の思想でも仕事のやり方として読み替える、という話をしました。「工場の話だから自分には関係ない」は誤解です。テストの中身がプログラムでも、「中くらいの設定で足りる仕事がある」という見方は、お礼メールにも社内向けの案内文にも読み替えて試せます。
今日そのまま試せる3つの手順と指示文
ここからは、記事を閉じてすぐに試せる手順です。道具は、ふだん使っているClaudeのアプリだけで構いません。
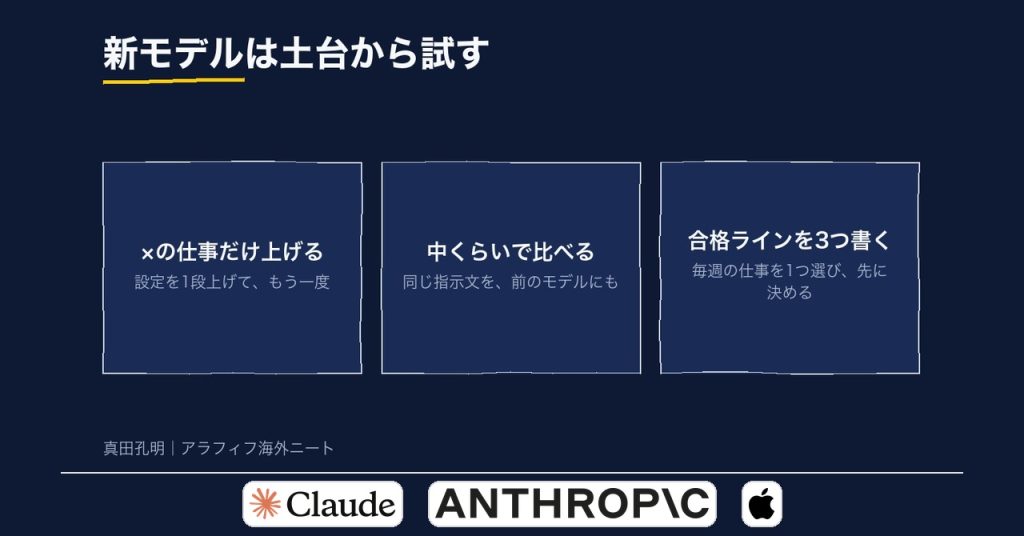
手順1:毎週くり返している仕事を1つだけ選びます。取引先へのお礼メール、会議メモの清書、商品の説明文など、出来の良し悪しを自分で判断できるものがよいです。そして、頼む前に「合格ライン」を3つ書き出します。ここが土台になります。
手順2:考える深さは初期設定の中くらいのまま、新しいモデルに次の指示文で頼みます。同じ指示文を、前のモデルにも渡します。〔 〕の中を書き換えるだけで使えます。
これから〔毎週の仕事:例 取引先へのお礼メール〕をお願いします。
先に、この仕事の合格ラインを伝えます。
1. 〔例:相手の名前と、打ち合わせで話した内容に1つ触れている〕
2. 〔例:300字以内〕
3. 〔例:次の約束の日時がはっきり書いてある〕
この3つを守って、下の材料から1本書いてください。
材料:〔会議メモや箇条書きを貼る〕
手順3:2つの答えについて、返ってくるまでの待ち時間と、自分で手直しした回数を書き留めます。費用の見え方は契約の形によって違うので、分かる範囲で記録してください。そのうえで、どちらがどのモデルの答えかを伏せて、次の指示文で採点させます。
下の2つの文章を、さきほどの合格ライン3つで採点してください。
各項目を○か×で示し、×の理由を1行で書いてください。
最後に、手直しなしで出せるのはどちらか?を一言で答えてください。
文章A:〔1つ目の答えを貼る〕
文章B:〔2つ目の答えを貼る〕
最後の判断は、自分でします。中くらいで合格ラインを満たすなら、その仕事は中くらいで足ります。×が出た項目があるときだけ、設定を1段上げて、同じ手順をもう一度回してください。
僕なら、中くらいのまま1つの仕事で比べる
今回の新しいモデルの話を、個人でできる対策にまとめると、次の4つになります。
・初期設定の中くらいから始め、いきなりいちばん深い設定にしない
・比べる仕事は1つに絞り、同じ指示文で前のモデルと並べる
・合格ラインを先に書き、モデルが変わっても同じ線で測る
・中くらいで×が出た仕事だけ、設定を1段上げる
慎重すぎる、と感じる方もいるでしょう。性能が上がって費用が半分なら、全部の仕事を一気に切り替えたくなるのが自然です。ただ、紹介されている数字はコーディングのテストでの成績で、あなたの会社のお礼メールで測ったものではありません。自分の仕事で確かめた数字だけが、明日からの判断に使えます。気をつけすぎているのではなく、自分の物差しで測り直しているだけです。
僕は物販・飲食・情報・サービスの4つの事業を回していますが、僕なら事業ごとに別の基準は作りません。土台となる基準を1つ決め、その上でどのモデルを使うかを選びます。第2回の講義で話した、OSとアプリの関係そのものです。基準が土台にあれば、Fable 5.2でもMythos 5.2でも、次に出るモデルでも、同じ手順で比べられます。毎回ゼロから迷わずにすみます。
AIは、使うものではなく、育てるものです。育てるというのは、新しいモデルが出るたびに乗り換えることではありません。自分の合格ラインを渡し、その線で答えを測り、足りないところだけ手を入れていくことです。
僕なら、今日はこうします。毎週のお礼メールを1つ選び、合格ラインを3つ書き、中くらいの設定のままFable 5.2と前のモデルに同じ指示文で頼む。それを1週間続けて、待ち時間と手直しの回数を並べる。記録がそろったところで、設定を上げるかどうかを決めます。新しい数字に反応するのは、そのあとで十分です。